Un sistema de control de versiones (o SCV) nos proporciona diferentes versiones de la codificación de un proyecto. Durante el proceso de desarrollo la aplicación va cambiando y es necesario en ocasiones volver a un estado anterior.
Esto puede deberse a que la nueva versión de algún problema, a que estemos realizando pruebas y no queremos perder lo anterior, o cuando trabajamos en equipo y diferentes desarrolladores están haciendo cambios en el programa.
El SCV realizar copias incrementales cada vez que generemos una versión, de tal modo que en cada nueva copia, marca los archivos cambiados y los alamacena.
Al crear estas versiones el programador puede:
- Restaurar parte o en su totalidad un desarrollo a una versión anterior.
- Comparar los cambios de la versión actual respecto a otra anterior.
- Acceso remoto: Proporcionar acceso remoto de elementos del repositorio a los usuarios con permisos para modificar, leer, mover, borrar etc.
- Registrar las modificaciones: Crear un registro de modificaciones efectuadas sobre la estructura de archivos que permita obtener estados previos.
- Control de cambios: Controlar que los usuarios siempre trabajan sobre la última versión del archivo. Para ello podrán utilizar sistemas de bloqueo o colaborativos, siendo este último el más aconsejado.
Tipos de control de versiones
En su forma mas básica un SVC lo que hace es realizar copias de los archivos que forman un proyecto. Cada copia se denomina versión y esta se puede almacenar en un repositorio local o un servidor remoto (o en ambos).
Cuando trabajamos con un grupo de personas es común que varias estén trabajando en las mismas partes de un código, por ello tenemos que asegurarnos de que cuando se realicen cambios todos lo estén haciendo en la versión correcta. Por lo que existirán, no solo diferentes versiones, además están almacenadas en diferentes lugares según sea el caso.
Existen dos formas de estructurar un SVC.
Sistemas centralizados
Los sistemas centralizados son aquellos en los que existe un único servidor que contiene el repositorio completo y los desarrolladores acceden a el para realizar los cambios en su espacio de trabajo, para luego crear una nueva versión en el servidor con los cambios.
En el siguiente gráfico podemos ver como sería su estructura básica.
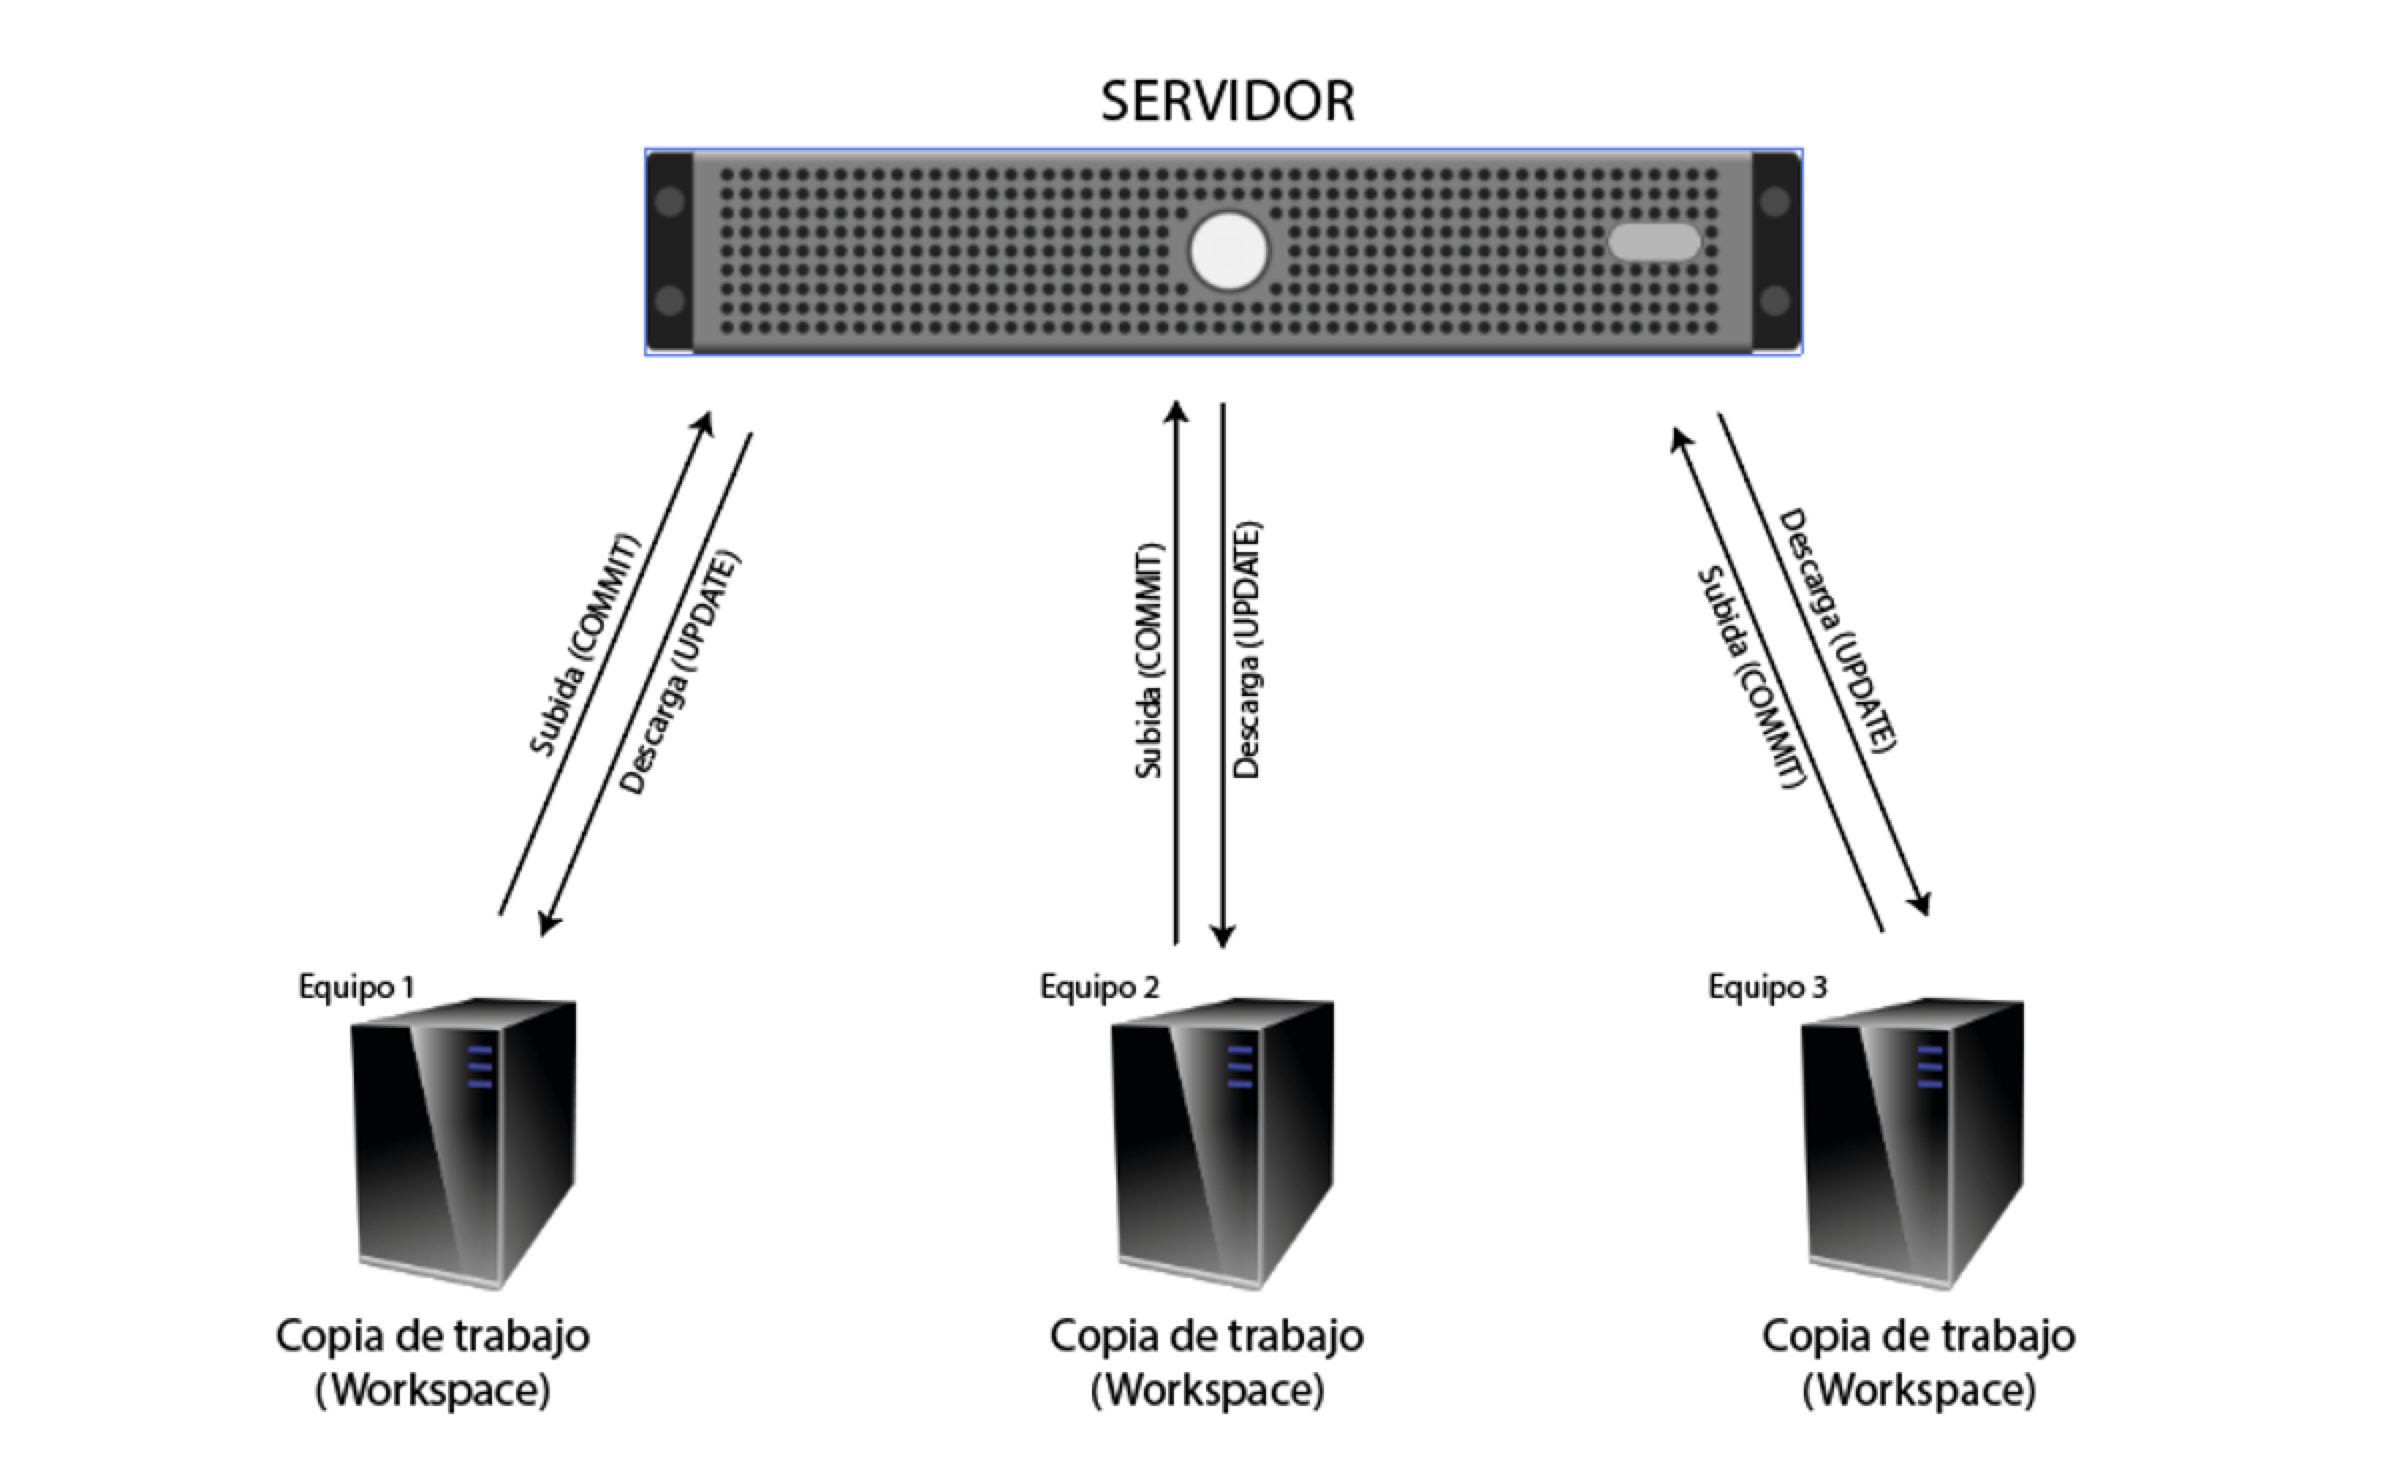
En el gráfico anterior vemos como los usuarios de los diferentes equipos, por medio de una orden “update”, obtiene una copia de trabajo de la versión requerida, procedente del repositorio del servidor.
Una vez realizado el cambio en la copia de forma local mediante la orden “commit” envía los cambios realizados en la versión al servidor.
De tal modo que cuando un nuevo usuario quiera trabajar sobre un código podrá acceder a la ultima versión del proyecto realizando un nuevo UPDATE. Es importante entender que normalmente un proyecto consta de diferentes archivos, por lo que es común que no puedan trabajar sobre el mismo en concurrencia.
Existen formas de que dos programadores trabajen sobre el mismo archivo, realizando fusiones, pero en estos casos debe estar muy especificada la tarea de cada uno de ellos y siempre se debe de comprobar.
Aunque el sistema realice una combinación de forma automática, una fusión siempre deberá ser verificada de forma manual. El hecho de que el programa haya sido capaz de añadir líneas o eliminar archivos sin que se detecte conflicto, no es sinónimo de que el código vaya a poder ejecutarse de manera correcta.
Sistemas distribuidos
Los usuarios disponen de un repositorio completo en sus equipos locales.
El funcionamiento podría describirse de la siguiente manera.
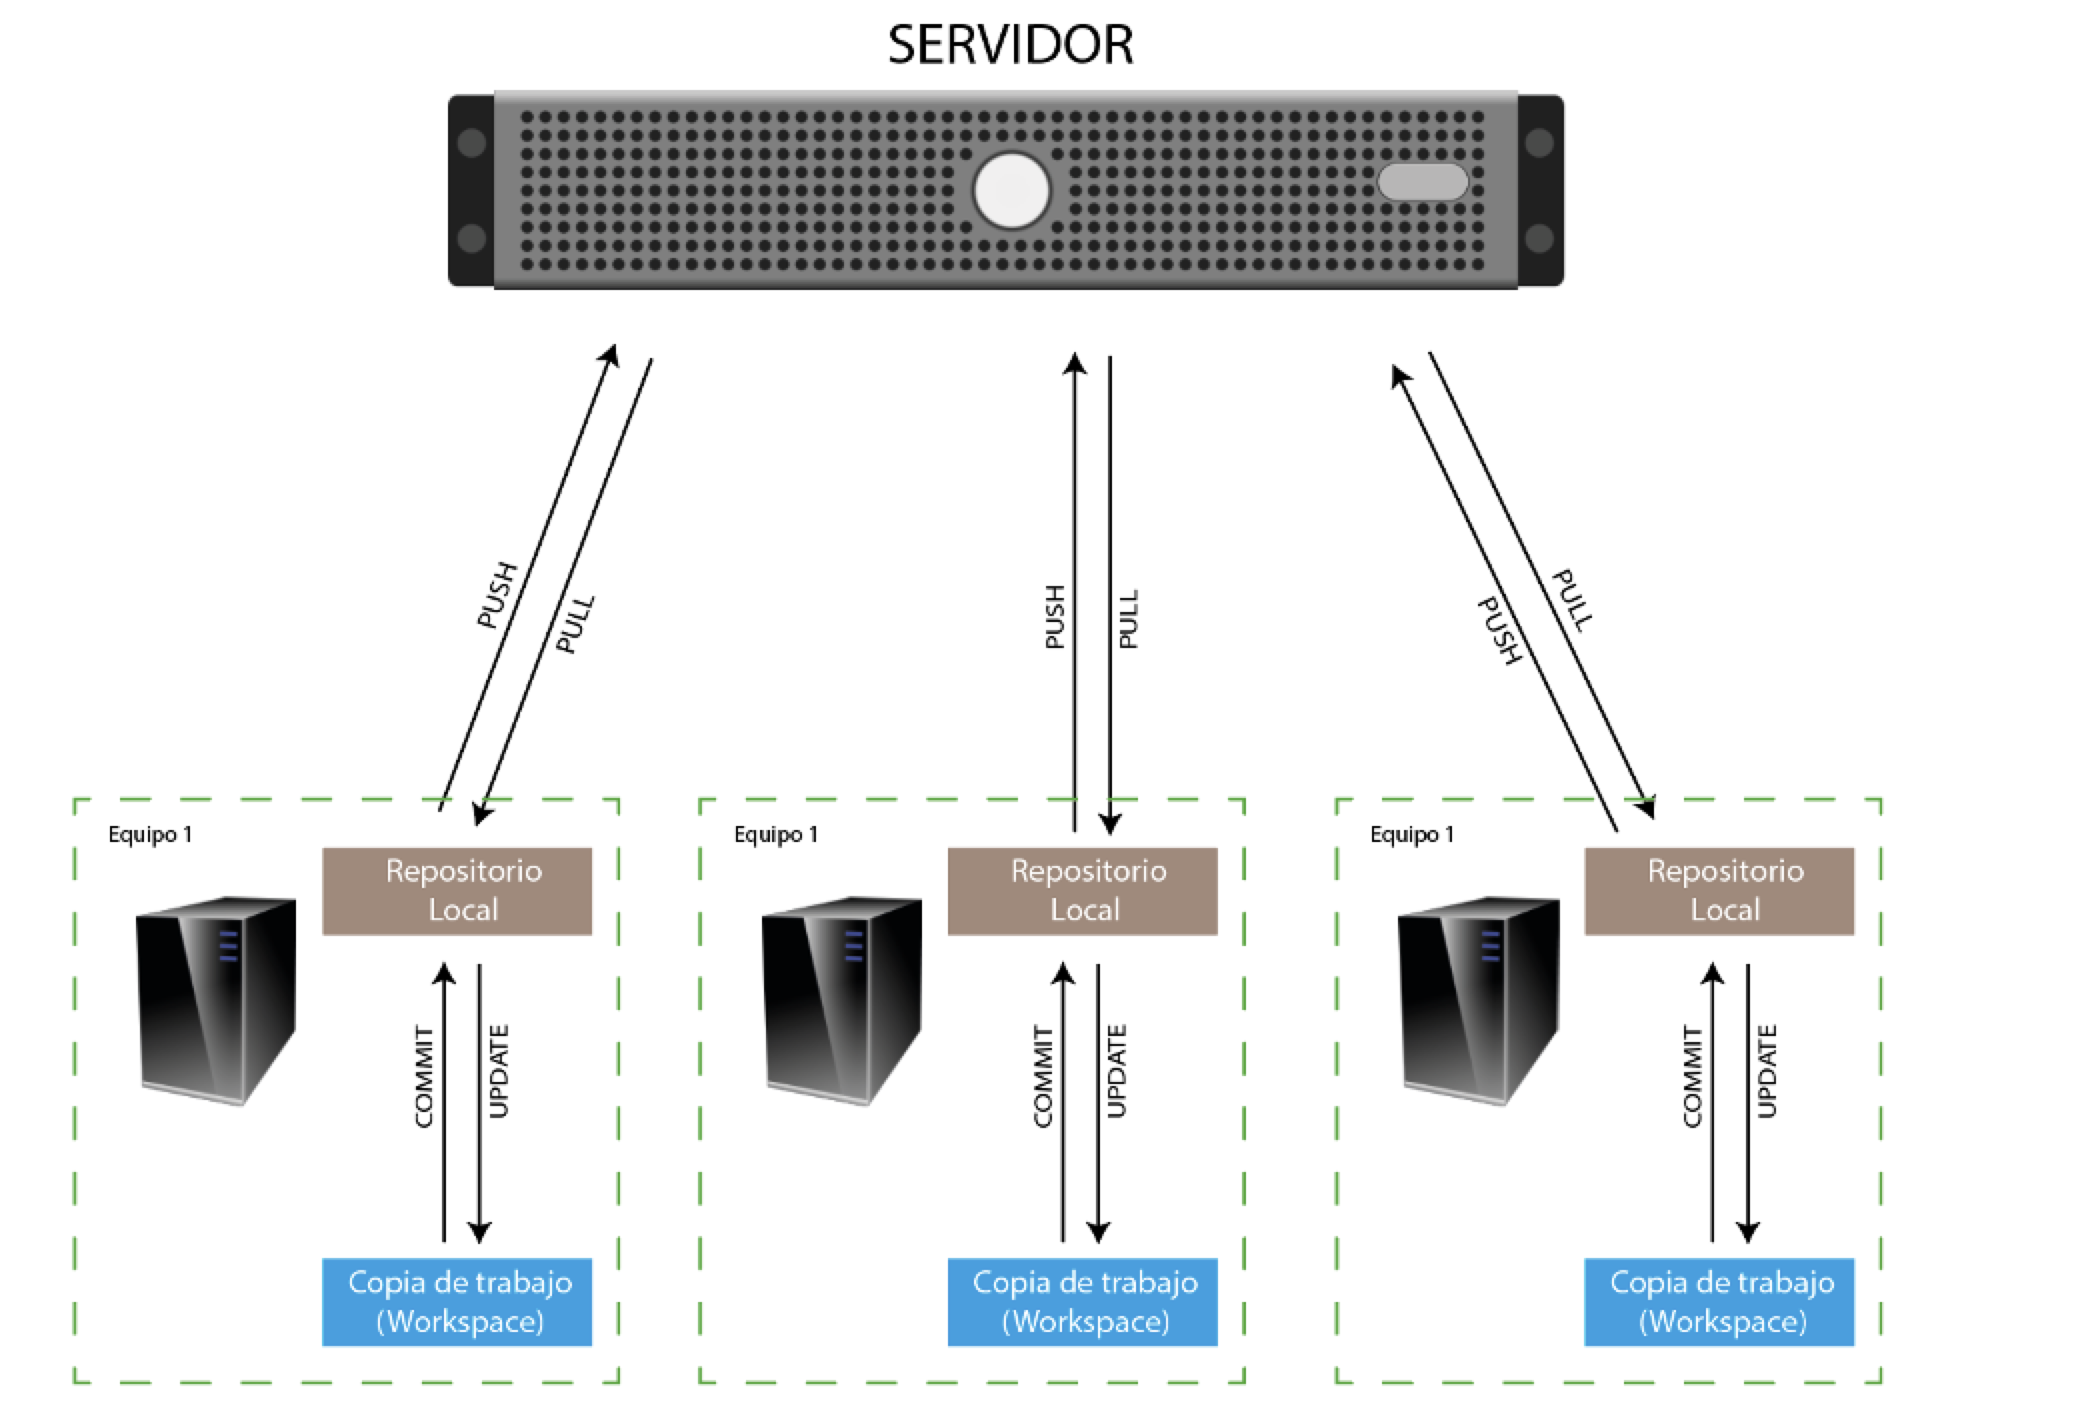
En los sistemas distribuidos un usuario accede por primera vez al sistema y, por medio de la orden “pull”, descarga el repositorio completo desde el servidor hasta su equipo local.
El usuario, por medio de la orden “update”, obtiene una copia de trabajo procedente del repositorio de su equipo.
Una vez realiza los cambios por medio de una orden “commit” guarda los cambios realizados al repositorio local de su equipo.
- Si desea que los cambios de su repositorio local se hagan efectivos en el servidor deberá hacerlo por medio de la orden “push”.
| Centralizado | Distribuido | |
| Ventajas | El repositorio se gestiona de manera más sencilla. | Ante una caída del servidor se puede recuperar el repositorio íntegro desde cualquiera de los equipos. |
| Desventajas | Ante una caída del servidor central no será posible respaldar los datos.
Las copias del repositorio central deben ser más frecuentes al contar con un único repositorio. |
Cuando se propagan los cambios del repositorio de un usuario se obtienen elevados tiempos de actualización y mayor tráfico de datos.
Al trabajar con repositorios locales las actualizaciones hacia el resto de usuarios suelen realizarse menos frecuentemente. |
Gestión y administración
Repositorios
Los repositorios son los amacenes donde se guardan los datos, estos son una secuencia de estados de las estructuras de archivos y directorios almacenados a lo largo del tiempo.
Inicialmente el repositorio estará vacio, pero según realziamos envios (commits) se iran añadiendo al repositorio, guardando el estado anterior y el nuevo.
De tal forma que al ir enviando archivos sucesivamente se van guardando de forma incremental cada una de las estructuras en versiones, a las que el usuario puede acceder cuando lo requiera.
Publicación de cambios «commit»
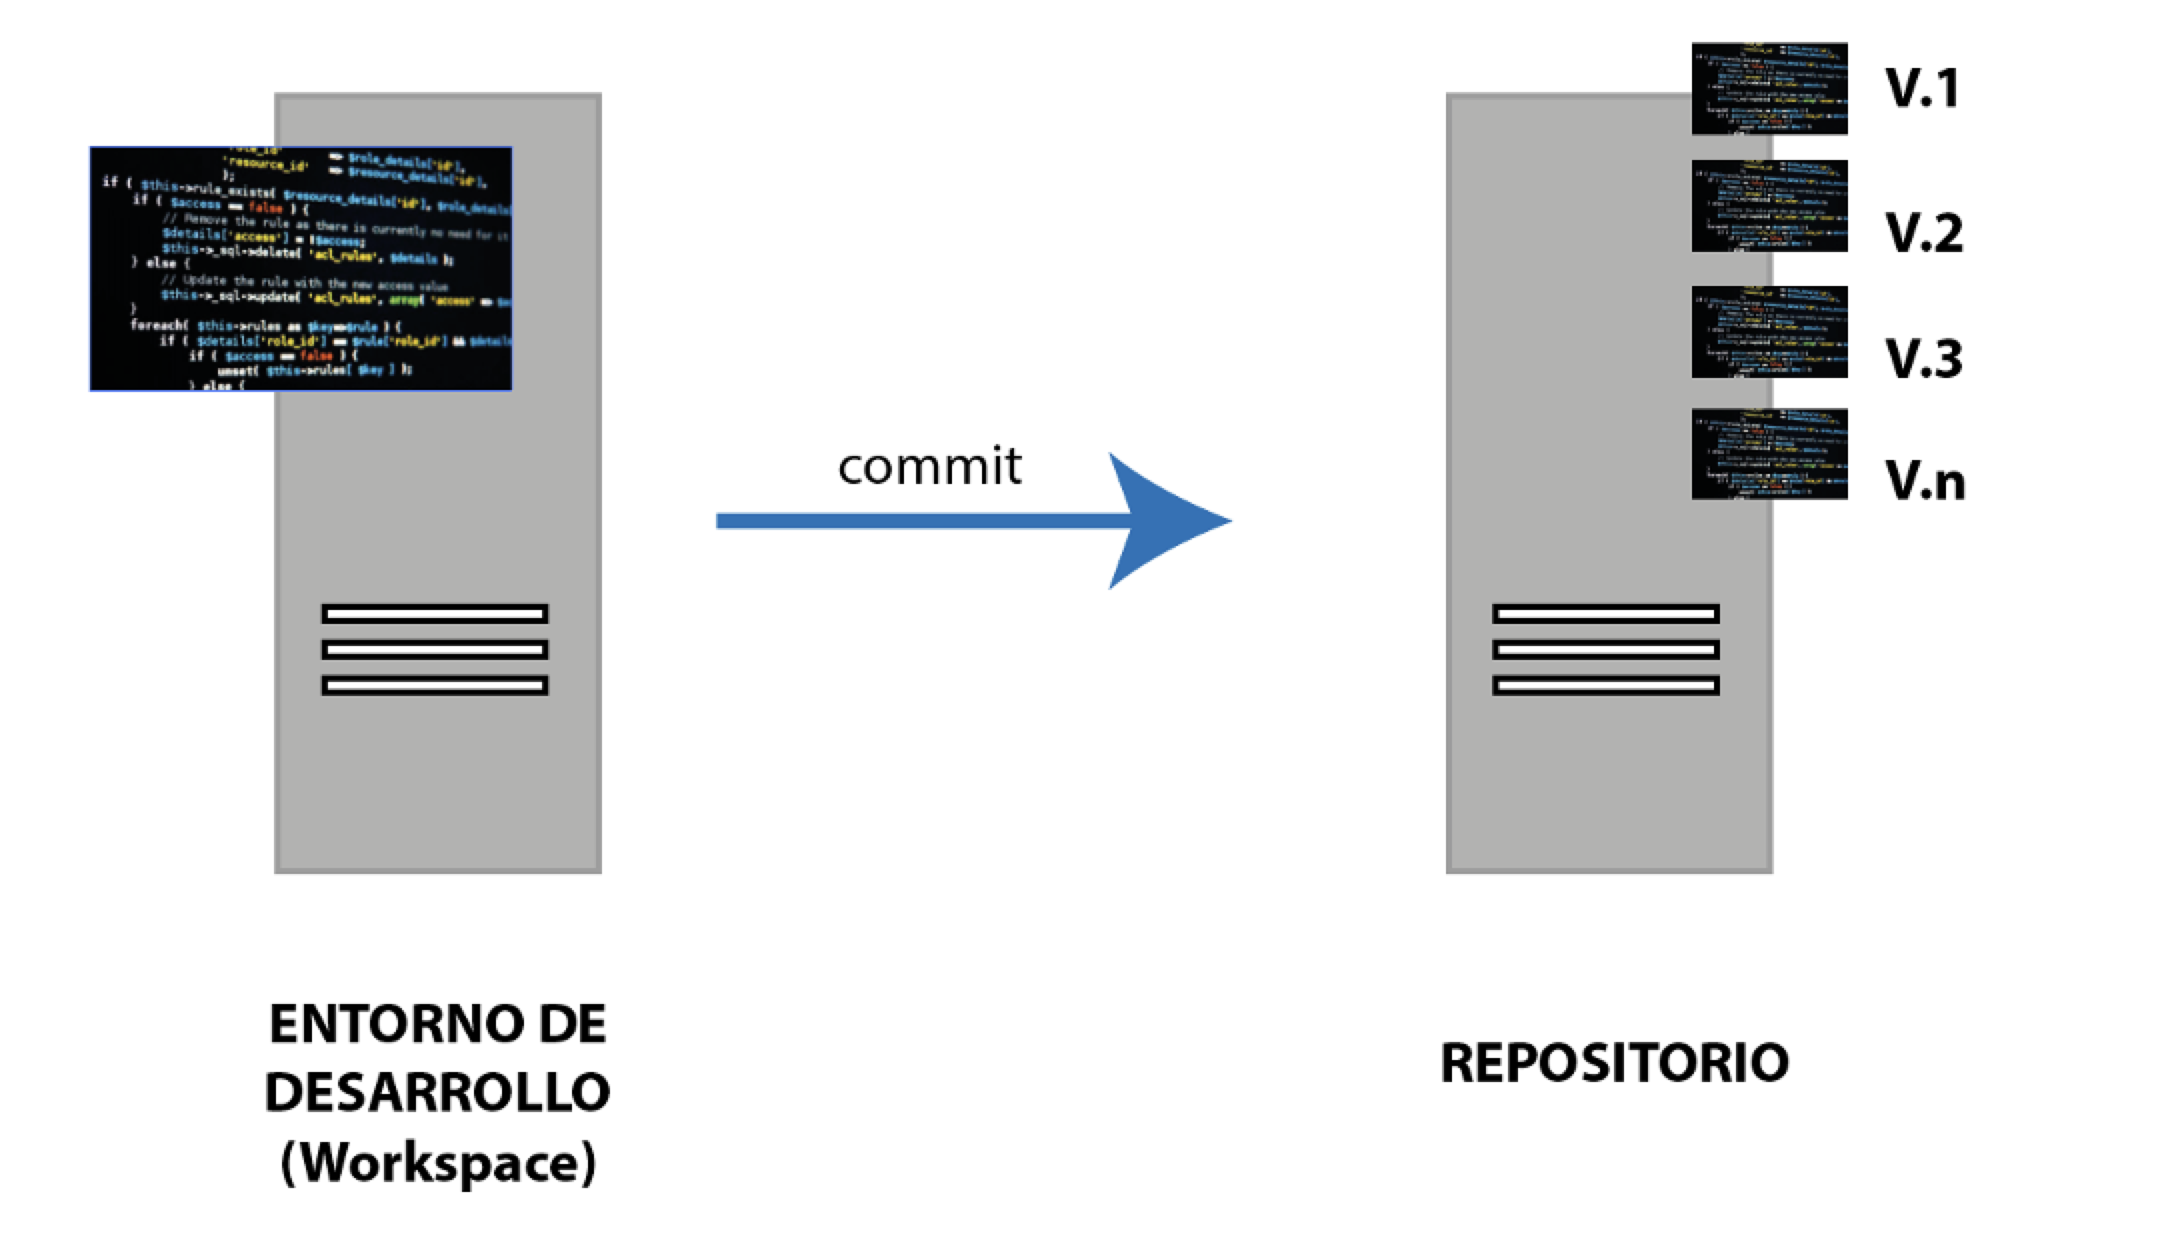
Cuando trabajamos en el software lo hacemos en la copia de trabajo (workspace) donde el programador realiza los códigos del programa. Cuando ha realizado los cambios en el software o ha realizado nuevas partes de código. Esta nueva codificación se envía al repositorio.
Este proceso de envío donde se envía los cambios del programa al repositorio se llama “check-in” o “commit”. Esta operación provocará que el sistema cree una nueva versión (cuyo número será el que existía en la estructura del repositorio +1) de la estructura de archivos y que se genere un nuevo registro de la BBDD con los datos del cambio introducido.
Despliegue o «check-out»
Se denomina despliegue o check-out al proceso en el que el usario descarga o actualiza su copia de trabajo o worsksapce desde el repositorio, es el proceso contrario al commit.
Debemos tener cuidado, pues si realizamos un check-out, teniendo cambios en local, los perderemos irremediablemente, al no estar dentro del proceso de versiones.
Lo mas habitual es recuperar la última versión disponible, pero podemos recuperar cualquier de los estados que tenga nuestro repositorio. Además cada una de las versiones contiene información sobre los cambios realizados y en caso de trabajo en equipo quien los realizo.
Cuando trabajamos en equipo puede darse la situación de que dos desarrolladores suban cambios procedentes del mismo repositorio, lo que provoca que existan dos versiones diferentes con parte del código definitivo en las dos últimas versiones.
Para evitar el problema de pérdidas de versiones el sistema puede optar por adoptar alguna de las siguientes soluciones:
- Check-out exclusivo: De tal forma que una vez que el usuario A realiza su despliegue bloquea la versión que es descargada, y por tanto se impide que cualquier otro usuario haga cambios en la versión.
El bloqueo de la versión durará hasta que el usuario A haya finalizado los cambios y realice un “commit”.
- En el que el usuario hará un despliegue de una versión sin bloquearla, por lo que permitirá que cualquier otro usuario realice cambios en la versión, que serán combinados.
Ramas «branching»
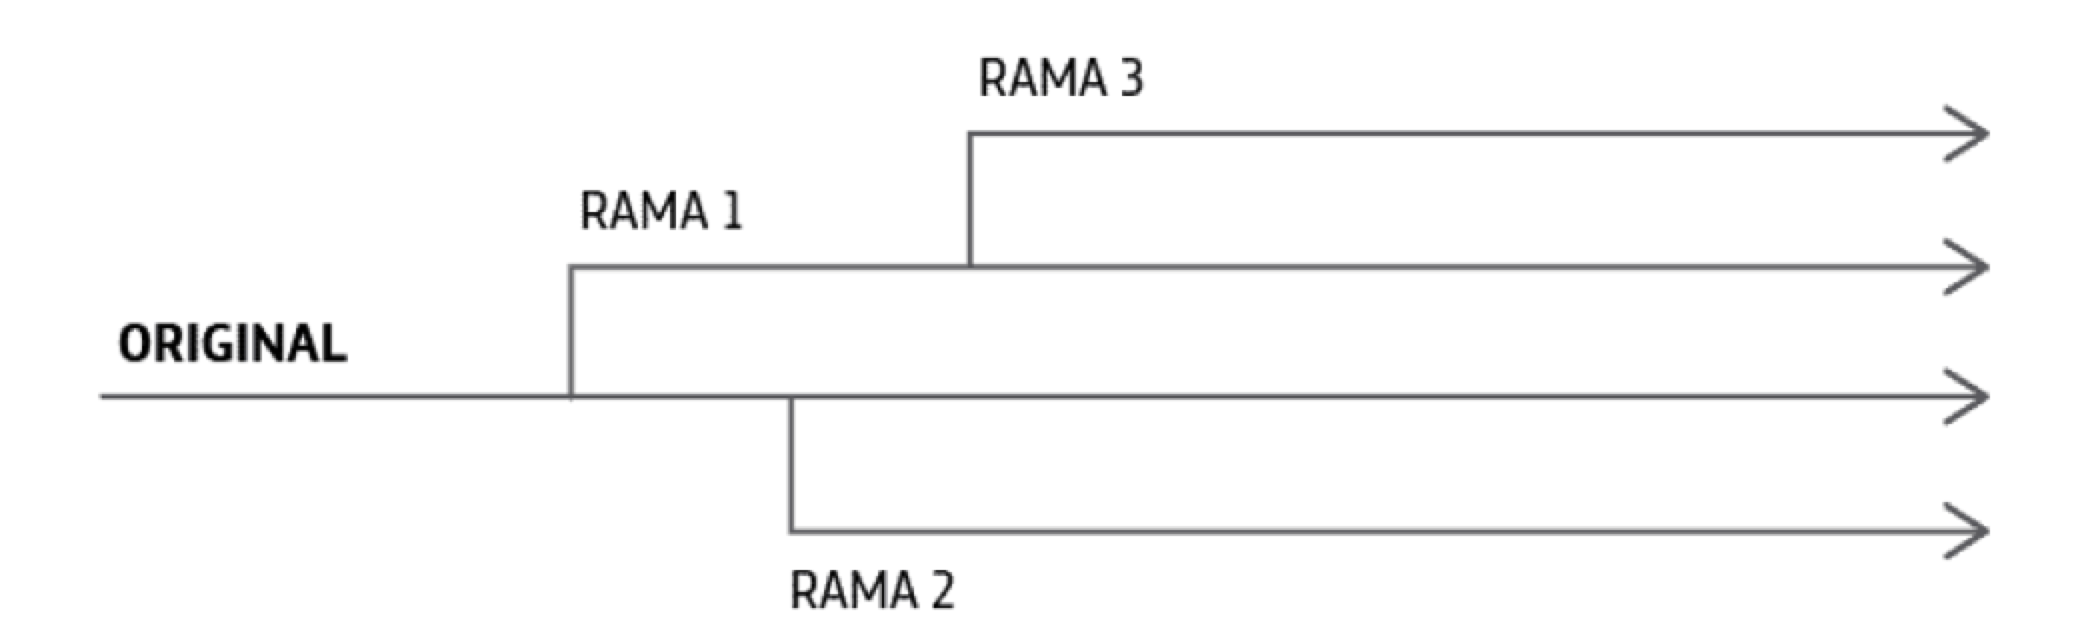
Muchas veces en la realización de un proyecto se requiere la realización de versiones en paralelo. Es decir, a partir de una versión común, evolucionarla por dos vías o “ramas” (branches) distintas.
En ocasiones, puede ser por que se comercializa una nueva versión con funcionabilidades avanzadas, por que se esta adaptando para otras plataformas o simplemente por que deseamos realzar un desarrollo de pruebas sin perder la posibilidad de evolucionar otra de las versiones.
Fusiones «merging»
Cuando un archivo sufre modificaciones por diferentes usuarios, tenemos que realizar una fusión o “merging”. Esto puede deberse a que dos usuarios han realizado un “update” en una misma versión, o bien cuando son enviados al repositorio por medio de “commit” en un sistema de despliegue colaborativo.
Aunque el sistema realice una combinación de forma automática, una fusión siempre deberá ser verificada de forma manual. El hecho de que el programa haya sido capaz de añadir líneas o eliminar archivos sin que se detecte conflicto, no es sinónimo de que el código vaya a poder ejecutarse de manera correcta.
Etiquetado («tagging»)
Una etiqueta es un estado o versión de una estructura de archivos determinada, a la que se denomina con un nombre identificativo.
Uno de los motivos de poner una etiqueta o marca a una versión es la de poder identificar un hito o punto importante en el desarrollo del proyecto, como puede ser la finalización de una versión o una entrega del producto al cliente.
En este caso se haría necesario mantener inalterada y localizada la versión a partir de la cual se obtuvo la versión de producción, por si fuera necesario realizar algún cambio debido a errores detectados en la entrega.
Para la mayoría de los sistemas de control de versiones, una etiqueta es tratada como la creación de una rama a partir de la copia de una versión principal del desarrollo y es alojada en un directorio donde no se evolucionan nuevas versiones.
Herramientas para el control de versiones
Sistemas de gestión de versiones
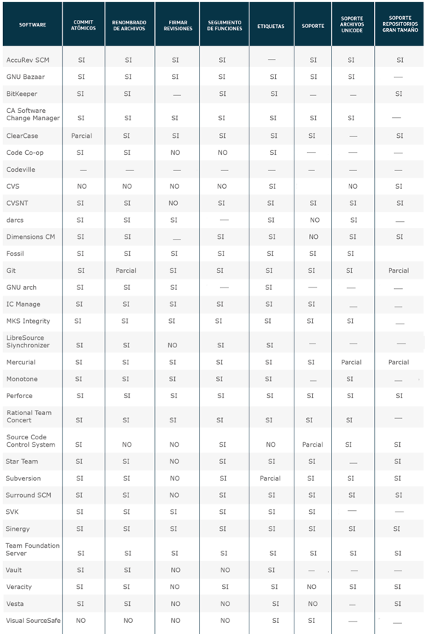
Existen una gran variedad de herramientas que proporcionan un sistema de control de versiones. Cada una incorpora una serie de características que habrán de ser tenidas en cuenta a la hora de seleccionar el sistema que más se acerque a nuestros requerimientos.
Se pueden enunciar las siguientes características básicas:
- Tipo de repositorio que incorpora: central o distribuido.
- Tipo de despliegue: exclusivos o colaborativos.
- Soporte para “commit” atómicos.
- Soporte para gestión de directorios.
- Capacidad de mostrar árboles de otros sistemas.
- Protocolos de red soportados (HTTP, SSH.FTP, SMTP, POP3).
- Soporte de etiquetas.
- Posibilidad de firmar versiones.
- Soporte con sistemas operativos.
- Tipo de cliente de acceso: propio o de fabricante externo.
- Integración con herramientas de desarrollo.
- Posibilidad de integración de sistemas de autenticación estándar.
- Tipo de licencia.
- Compatibilidad con nombres Unicode.
- Capacidad de almacenamiento del repositorio.
A continuación se expone un cuadro que relaciona los principales sistemas de control de versiones con características básicas obtenidas de la fuente “Wikipedia-Inglés”.