Introducción
En el ámbito de los negocios, un modelo de datos es una estructura abstracta que documenta y organiza la información para la comunicación entre el personal del departamento técnico y el resto de los empleados. En la informática, difiere en cuanto a su enfoque, el cual se centra en el planeamiento del desarrollo de aplicaciones y la decisión de cómo se almacenarán los datos y cómo se accederá a ellos.
A menudo especificados en un lenguaje, los modelos de datos determinan la estructura de la información, con el objetivo de mejorar la comunicación y la precisión en aplicaciones que usan e intercambian datos. Son terrenos comunes en los cuales los miembros de un equipo de trabajo con diferentes niveles de experiencia y conocimientos técnicos pueden interactuar sin problemas, dado que estos modelos deben tener una única interpretación.
Los modelos de datos son esenciales para el desarrollo de sistemas de información, ya que a través de ellos puede conseguirse la compatibilidad necesaria para manejar cantidades colosales de datos. Además, si se utilizan las mismas estructuras para el almacenamiento y el acceso, entonces distintas aplicaciones pueden compartir información. Un claro ejemplo es un formulario de registro en una página de Internet, donde para nuestro nombre sólo podemos ingresar letras, y para nuestra fecha de nacimiento, números con un orden específico (como ser día, mes y año). Estas restricciones responden a necesidades de la base de datos y deberían ser iguales en dos bases entre las que se quisiera compartir información.
Como contrapartida de la gran eficiencia que ofrecen, se encuentra el alto costo del desarrollo, la operación y el mantenimiento de los sistemas y las interfaces. Muchas veces, si la calidad de los modelos de datos implementados es pobre, se convierten en obstáculos para el crecimiento de una empresa. Generalmente, esto salta a la vista cuando una compañía que nunca invirtió muchos recursos en su infraestructura digital decide que quiere modernizarse y descubre que cuenta con una base de datos tan ineficiente y mal concebida, que resultaría más sencillo y menos costoso reconstruir todo desde el comienzo.
De acuerdo con el Instituto Nacional Estadounidense de Estándares (ANSI) un modelo de datos se puede interpretar como un esquema:
- Conceptual, que especifica las expresiones permitidas por el modelo mismo, comunica las reglas y definiciones esenciales de los datos a los usuarios;
- Lógico, que describe la semántica de tablas y columnas, clases orientadas a objetos, etcétera, representada por una tecnología de manipulación en particular (como ser el lenguaje SQL);
- Físico, que detalla los medios en los que se almacena la información, como ser particiones de disco.
Tipos de modelos de bases de datos
Modelo de tabla: su definición puede no responder estrictamente a un modelo; consiste de una lista de datos de dos dimensiones, en la cual todos los elementos de una columna determinada son similares y todos los valores de una fila tienen relación entre sí.
Modelo jerárquico: la información se organiza en una estructura de tipo árbol, anidados de forma que cada elemento pueda ramificarse en muchos otros, que deberán poder ordenarse de alguna forma.
Modelo de red: estructura la información utilizando dos construcciones fundamentales, llamadas récords (registros) y sets (conjuntos); los primeros contienen campos y los últimos definen relaciones entre los registros de uno a muchos (ej: un cliente, muchos productos comprados).
Esquema de estrella: consta generalmente de una tabla principal, a la se asocian muchas otras. Un ejemplo común es almacenar los datos de un paciente en una tabla, que a la vez se relacionará con otra donde consten todas sus consultas, y con otra en la que se registran sus reclamos o sus cambios de planes de cobertura, y así sucesivamente.
Tipos de datos
Básicos
Los tipos básicos de datos son los tipos elementales que un modelo de datos manejará. No pueden ser descompuestos en datos de un nivel inferior. No son datos que contienen más datos en su interior.
Algunos tipos de dato básicos son estos:
- Números enteros: simplemente un número sin decimales, por ejemplo, 100, 99, -30.
- Caracteres: por ejemplo, la palabra “hola”.
- Números con decimales: por ejemplo, 29’30, 3’1416.
- Datos booleanos: true/false, verdadero/falso.
Son datos aislados, no guardan relación con otros datos por sí mismos. Recuerde que un dato puede ser cualquier cosa, pero un dato básico se caracteriza porque no puede ser descompuesto en otros datos y porque no tiene relación con otros datos, como sí pueden tenerla los registros y los datos dinámicos.
Registros
Los registros son un conjunto de datos formando una estructura. Dentro de un registro puede haber datos que, a su vez, sean otras estructuras.
Un registro podría contener la información siguiente:
- Nombre: Carlos
- Edad: 42 años
- Nacionalidad: Española
El nombre de cada elemento tiene el nombre de campo.
Dentro de un registro puede haber un campo que sea otra estructura. El registro del ejemplo podría tener otro campo llamado “Hijos” que contuviera, a su vez, otras personas dentro.
Aplicado al campo de las bases de datos, un registro es una fila de una tabla de datos en la que todos sus elementos siguen la misma estructura.
Ciclo de vida de los datos
Un dato es un valor. Un dato es la unidad mínima con la que trabaja un sistema de información. No confundir “sistema informático” con “sistema de información”. En un sistema informático la unidad mínima es un bit (un uno o un cero); el sistema de información se coloca en una capa superior.
Piense en un dato como en un valor: el número 23 o el texto “hola” serían perfectos ejemplos de qué es un dato.
Un dato no contiene información. Es simplemente un valor. Para que contenga información, para que sea de utilidad, un dato debe ser procesado. El ciclo de vida de un dato es el siguiente:
- Creación del dato. Estos datos pueden ser creados manualmente por un usuario o automáticamente de forma informática en base a un evento o suceso. El modelo de datos se encargará de definir la manera en la que esos datos serán almacenados y si son aceptados o no.
- Manipulación. Si los datos sufren modificaciones, el modelo de datos definirá la manera en la que se podrán mantener esos datos actualizados. El concepto “manipulación” incluye el consultar los datos para su uso.
- Destrucción. Debe ser posible destruir esos datos cuando deja de ser necesario su almacenamiento.
El modelo relacional
El modelo relacional es un modelo de datos utilizado para representar datos interrelacionados.
Es el modelo más utilizado en las aplicaciones de procesamiento de datos porque es muy potente al representar los datos. Fue desarrollado por Edgar Frank Codd en 1970, miembro de IBM. Está basado en el concepto de que la estructura básica es la “relación”. Los datos se almacenan en relaciones (tablas) y estas, a su vez, se relacionan con otras tablas.
Piense en una “relación” como en un tipo de objeto. Estos datos se almacenarán en tablas y se relacionarán con otras tablas.
Para el modelo relacional suele utilizarse una representación gráfica de cada objeto y sus relaciones. De esta manera el administrador de base de datos podrá crear fácilmente la base de datos siguiendo las indicaciones creadas por el analista informático.
La representación gráfica utilizada para representar modelos relacionales son los diagramas de entidad/relación. Estos diagramas nos permiten leer un modelo de datos de forma visual.
Los diagramas entidad/relación no cumplen el modelo relacional a rajatabla. Habrá que realizar una serie de transformaciones para que así sea. Estos diagramas se utilizan únicamente con fines informativos para poder entender cómo implementar ese modelo de datos. El modelo relacional sí se utiliza para el almacenamiento físico de los datos.
A lo largo de este apartado se explicará el modelo relacional junto a cómo se representa cada elemento mediante diagramas de entidad/relación.
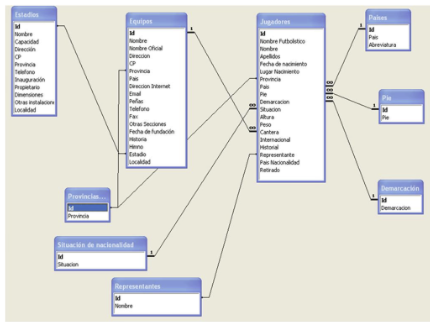
El modelo relacional está basado en el modelo relacional matemático. Su objetivo es separar el almacenamiento físico y otras características propias del sistema informático de la propia lógica de los datos.
De esta manera, el usuario del modelo de datos simplemente debe preocuparse de los datos que va a utilizar su aplicación, no de cómo se organizarán internamente.
La lista de objetivos es la siguiente:
Independencia física de los datos: la manera en que los datos estén organizados en el soporte físico utilizado (disco duro, disco extraíble, memoria RAM) no debe afectar en absoluto al modelo lógico utilizado. El modelo relacional añade una capa de abstracción que se encargará de manejar los datos internamente sin que el usuario tenga que definir cómo se guardarán.
Independencia lógica de los datos: si se cambia la lógica del modelo datos, esto no debe afectar al sistema informático que guarde los datos.
Encapsulamiento del comportamiento interno: el sistema que implemente el modelo relacional se encargará de manejar los datos, las relaciones y las restricciones internamente para hacer sencilla al usuario su utilización. Para el usuario será sencillo manipular los datos, puesto que estarán presentados mediante tablas y relaciones.
El creador del modelo relacional fue Edgar F. Codd. Tras unos años viendo cómo se implementaba su sistema en el mercado, vio que muchos usuarios no entendieron correctamente el concepto de relación. La mayoría simplemente almacenaba la información en tablas, pero sin unas reglas adecuadas de normalización y sin especificar las relaciones entre tablas correctamente. Por eso, en 1985 estableció las famosas 12 reglas de Codd (que en realidad son 13). Estas son las reglas que cualquier sistema que implemente el modelo relacional debe seguir:
Regla 0: el sistema debe ser relacional, tanto como base de datos como sistema de gestión. Un sistema de gestión de bases de datos relacional (RDBMS por sus siglas en inglés) debe utilizar sus opciones relacionales únicamente para gestionar la base de datos.
Esta regla es la regla básica y afirma que el sistema de base de datos debe contar con un sistema que gestione las relaciones de forma eficaz y este sistema relacional solamente debe ser utilizado para gestionar la información que se encuentra en la base de datos.
Regla 1: regla de información. La información de la base de datos relacional estará alojada en tablas.
Regla 2: regla de acceso garantizado. Todos los datos almacenados en la base de datos deben ser accesibles. Cada registro de una tabla tendrá una clave primaria que será un dato único que representará a ese registro en la tabla. Cada dato será accesible, especificando el nombre de la tabla en que se encuentra y el valor de su clave primaria.
Regla 3: manejo sistemático de valores nulos. El sistema debe permitir a un campo tener un valor nulo (vacío). Esto será utilizado cuando un registro no disponga de un valor conocido para un campo determinado. El sistema gestor de base de datos deberá tratar estos valores de forma especial y diferente a los demás valores. Los valores nulos son independientes del tipo de dato del campo (texto, numérico, etc.) y son tratados siempre de la misma manera.
Regla 4: catálogo disponible basado en el modelo relacional. El sistema debe proporcionar una forma de acceder al catálogo del modelo relacional (lista de tablas, campos, relaciones, etc.) utilizando el mismo lenguaje de consulta empleado para acceder a los datos. A este catálogo se le llama diccionario de datos y se consulta mediante SQL.
Ejemplo: será tan posible ver la lista de registros de una tabla como ver la lista de tablas que están presentes en la base de datos de una forma unificada.
Regla 5: el sistema puede tener, a su vez, varios sistemas para comunicarse con la base de datos, pero debe haber un lenguaje unificado que:
Tenga una sintaxis lineal (que se lea de izquierda a derecha sin necesidad de saltos de línea).
Pueda ser utilizado de forma interactiva para comunicarse con la base de datos manualmente y también desde otras aplicaciones.
Soporte operaciones para definir el modelo de datos, operaciones de manipulación de datos, seguridad y restricciones de integridad además de gestión de transacciones.
Nota: el lenguaje unificado más utilizado es SQL (Structured Query Language), el cual se tratará en profundidad más adelante.
Regla 6: la regla de las vistas actualizables. Todas las vistas que sean teóricamente modificables deben ser modificables por el sistema.
Regla 7: alto nivel en alta, modificación y borrado de datos. El sistema debe ser capaz de proporcionar datos de tablas que estén recibiendo altas, bajas o modificaciones en sus registros en ese momento. Todos los registros de la tabla deben ser accesibles en cualquier momento, no importa que se estén modificando en ese preciso instante.
Regla 8: independencia física de los datos. Cambios internos en cómo están organizados físicamente los datos no deben afectar en absoluto al modelo relacional y no deben requerir cambios en la aplicación.
Ejemplo: si se actualiza el software del Sistema Gestor de Bases de Datos, el modelo relacional debe permanecer intacto y la aplicación que utilice la base de datos no debe necesitar cambios para seguir funcionando. Actualizar desde MySQL 5.1 a MySQL 5.6 no debe causar problemas (y así es).
Regla 9: independencia lógica de los datos. Cambios en el modelo de datos no deben afectar a las aplicaciones que utilice la base de datos. Esto es más difícil de conseguir que la independencia física de los datos, puesto que la lógica de los datos es definida por el usuario de la base de datos y normalmente, son requeridos cambios en el modelo de datos porque también se harán cambios en las aplicaciones que utilice la base de datos. Sin embargo, siempre se tratará de mantener la estructura de tal forma que las aplicaciones no necesiten cambios para seguir funcionando.
Regla 10: independencia de integridad. Las condiciones de integridad deben ser almacenadas en el catálogo de la base de datos (diccionario de datos) y ser independientes de la aplicación que la utilice. Debe ser posible cambiar las restricciones de integridad sin que eso requiera cambios en la aplicación.
Regla 11: independencia de distribución. La distribución de distintas partes de la base de datos no debe afectar al usuario de la misma. Las aplicaciones que utilicen la base de datos no deben notar cambios cuando un sistema de distribución de datos sea implementado por primera vez y tampoco cuando un sistema de distribución existente añada nuevos elementos a su red.
Ejemplo: en bases de datos de uso masivo es muy habitual el concepto de replicación. Esto consiste en tener la misma base de datos en múltiples servidores para dividir el trabajo, aumentando el rendimiento. Si se añaden nuevos servidores replicados, esto no debe afectar en absoluto al funcionamiento de la base de datos más que en un aumento del rendimiento.
Regla 12: regla de no subversión. Si el sistema ofrece un sistema de bajo nivel para modificar datos de la base de datos, este nunca debe poder permitir que se violen las restricciones de integridad de los datos.