Introducción
En esta unidad veremos qué es el DOM y para que sirve. El Modelo de Objetos del Documento (DOM) es una interfaz de programación de aplicaciones para documentos validos y bien construidos HTML y XML.
Las etiquetas son la estructura básica de los Html y XML. Estas etiquetas o tags se componen y contienen otras propiedades, como son los atributos o el contenido.
HTML y XHTML son las dos variantes que existen en el lenguaje HTML. Este lenguaje surgió como una forma de definir un documento pero nunca para darle formato.
Es en la versión HTML 3.2 es cuando comienzan a usarse etiquetas como <font> y otras que generan documentos HTML poco estructurados y con demasiadas etiquetas de formato. Estos documentos eran de alguna forma caóticos y poco claros. No se podía distinguir de forma sencilla la semántica, ni la estructura del documento.
La revisión de HTML 4 aportó la creación del etiquetado de estilos para definir por un lado el formato y por otro el contenido de un documento, estableciendo que:
- La página web (documento html) sólo debe contener información.
- El formato se debe definir en las llamadas hojas de estilo (CSS).
Las hojas de estilo son estructuras de marcas que definen el formato de los elementos. Se pueden incluir dentro del archivo HTML o fuera enlazando el archivo .css en nuestra página.
Actualmente estamos adoptando un nuevo estándar con HTML5, que junta varias tecnologías como HTML, CSS y Javascript, lo que dota a nuestros documentos de autentico dinamismo.
El DOM
El DOM se originó como una especificación para permitir que los lenguajes de programación pudieran interactuar con un estándar en la visualización y tratamiento de datos en los exploradores.
Al tener una estructura de árbol, los lenguajes pueden recorrer los elementos y modificarlos o leer su información, en el caso de las páginas web, esto se empezó a definir como HTML Dinámico. Dado que al poder alterar elementos independientes de un documento, podemos generar efectos o acciones partiendo de determinados eventos producidos por el sistema o por los usuarios.
El DOM es un estándar de W3C, para su realización unieron al grupo de trabajo que lo desarrollo compañías de otros ámbitos, incluyendo los de la edición y archivo de documentos HTML y XML, los cuales son herederos de SGML.
Como resultado, el DOM contiene una gran similitud con los procesos y estructura de SGML.
El Modelo de Objetos del Documento (DOM) es una interfaz de programación de aplicaciones para documentos validos y bien construidos HTML y XML.
Esta interfaz de programación define la estructura lógica de los documentos y el modo en que se accede y manipula un documento.
La palabra «documento» representa información que puede estar presentada en diferentes sistemas, pero el DOM permite crear documentos, navegar por su estructura, añadir, modificar y eliminar contenido.
La interfaz de El Modelo de Objetos del Documento (DOM) tiene una gran similitud con la estructura del documento al que modeliza.
De tal modo que si tenemos un código Html con una estructura básica:
|
1 2 3 4 5 6 7 8 9 |
<html> <head> <title>Mi documento</title> </head> <body> <h1>Título</h1> <p>Este es el <strong>Texto</strong> del documento</p> </body> </html> |
El árbol DOM generado, representara sus etiquetas y la jerarquía del mismo.
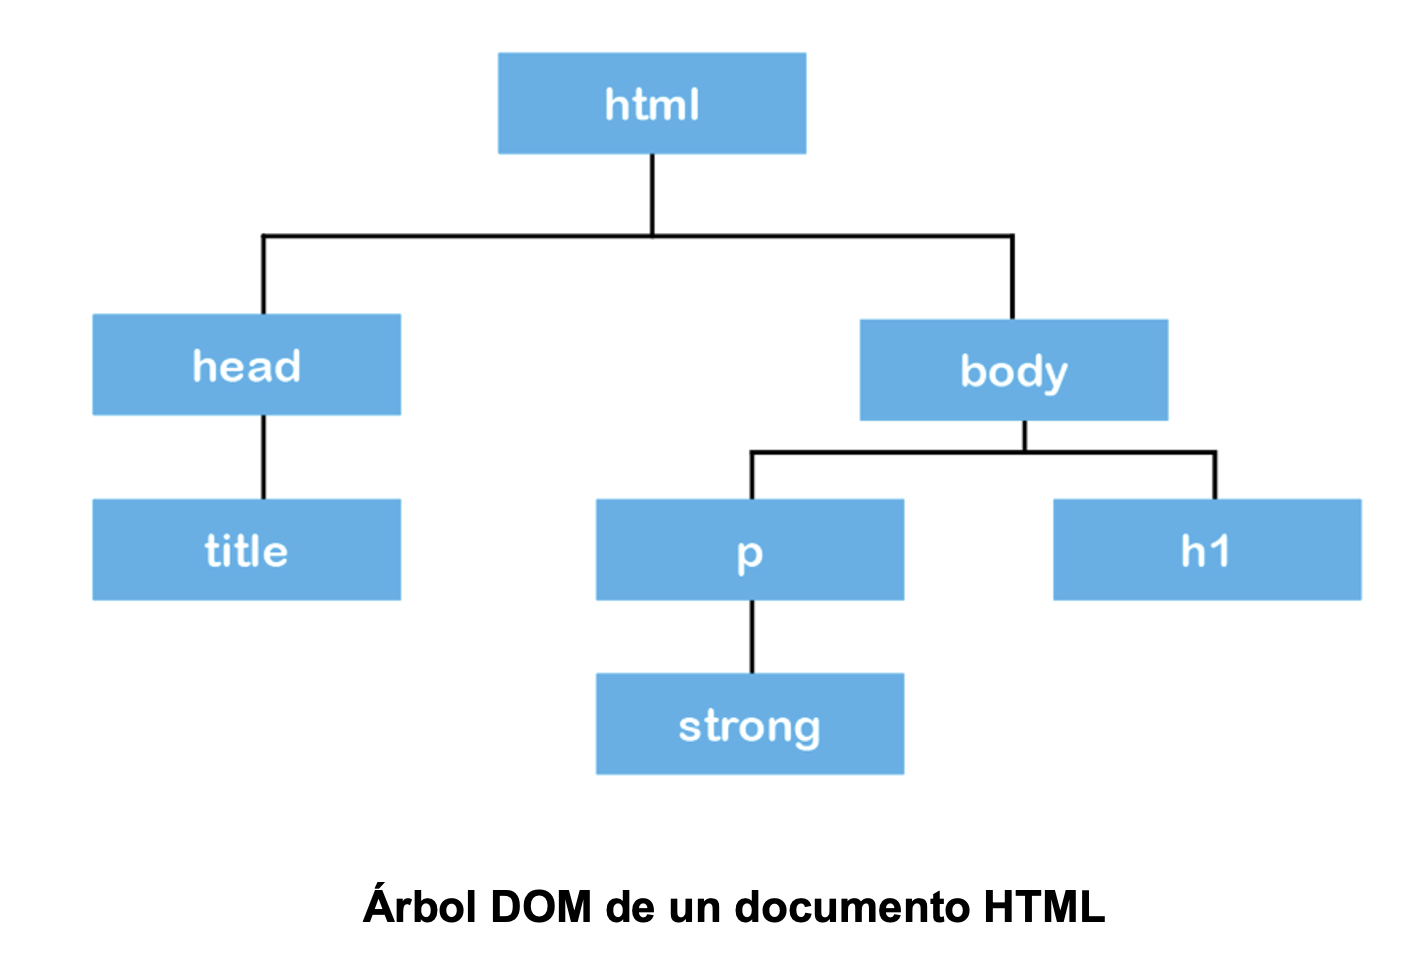
Por lo tanto esta especificación del W3C persigue que el Modelo de Objetos del Documento, proporcione una interfaz estándar que pueda ser utilizada en una variedad amplia de entornos y aplicaciones.
El DOM es reconocido por la mayor parte de los lenguajes de programación, por lo que se ha convertido en un estándar par ala generación de interfaces de las aplicaciones.
Tipos de nodos
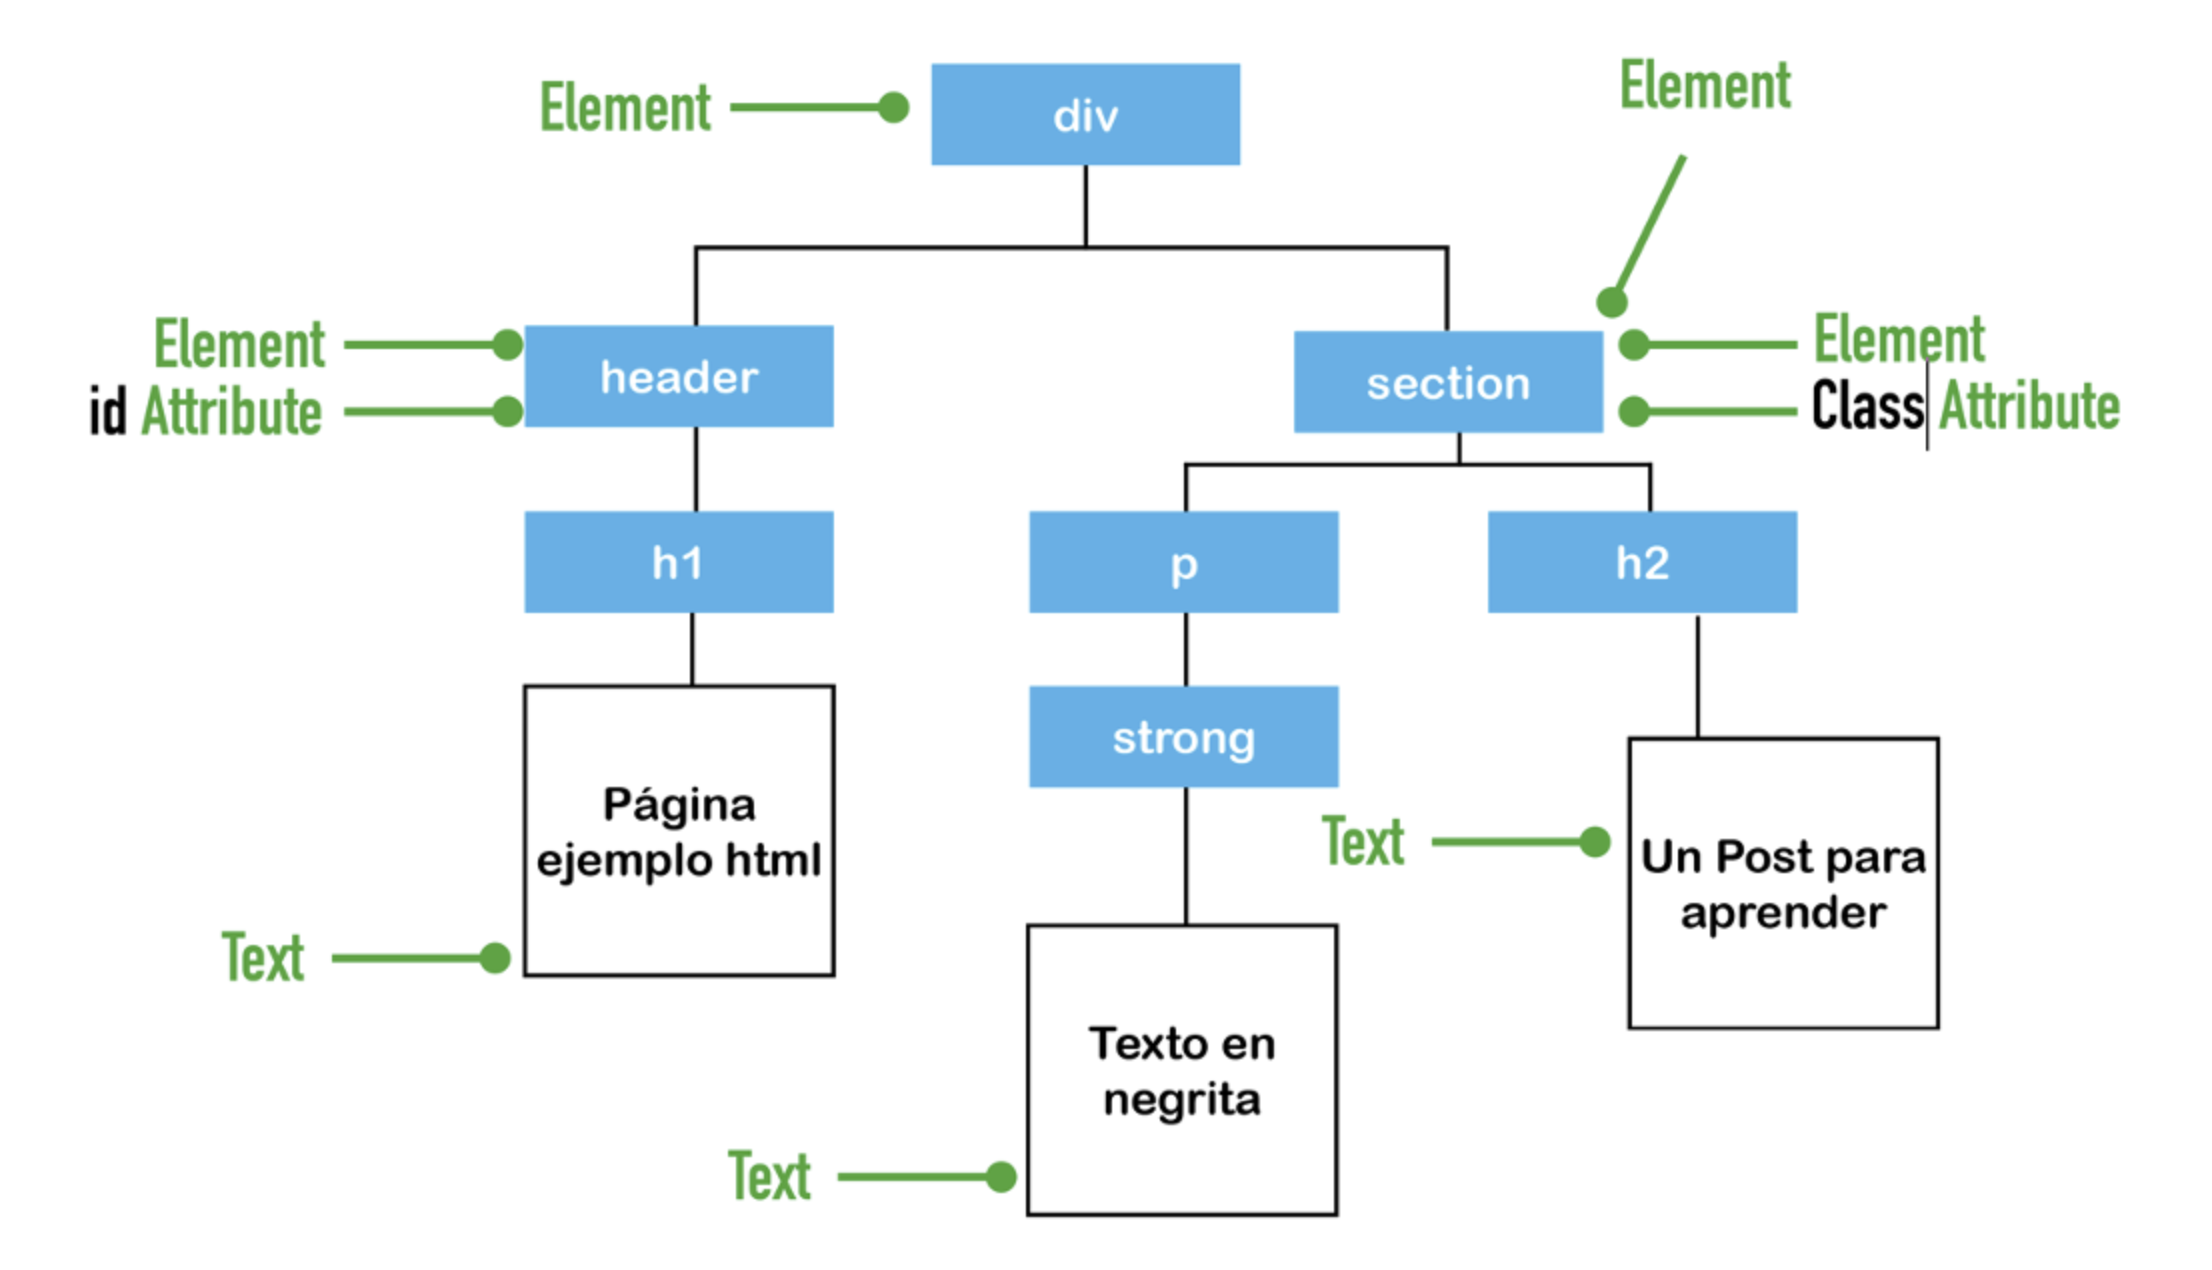
Como ya hemos comentado el DOM representa mediante un árbol los elementos de nuestro documento, cada uno de estos elementos da como resultado un nodo.
Los nodos derivan del objeto Node y existen diferentes tipos. En la siguiente lista podemos ver los principales:
a) Document: Es el nodo raíz del documento, en los documentos html, este simpre abrirá y cerrara el documento con la etiqueta <html>…</html>
b) Element: son los nodos definidos por etiquetas html. Existen multitud de etiquetas, estas son iterptetadas por los navegadores y le aplican normas especificas a cada una de ellas. Por ejemplo la etiqueta <p> es un párrafo, <img> es una imagen, <strong> indica negrita, etc.
c) Text: Es el contenido que contiene un elemento, se considera un nuevo nodo hijo de tipo text (texto). No todos los nodos elementos tienen que tener nodos de tipo text, pues pueden tener otro nodos o ningún contenido.
d) Attribute: Los atributos son propiedades de los propios nodos, estos pueden contener contenido o referencias para su identificación. Los atributos son puntos finales de la jerarquía pues no pueden contener otros nodos.
e) Comentarios: Existen otros tipos de nodos como los comentarios que no son visualizados en la pagina pero que si generan un nodo y los lenguajes de programación disponen de métodos para recorrerlos.
También tenemos otros elementos como las declaraciones doctype en cabecera de los documentos HTML.
Jerarquía de nodos
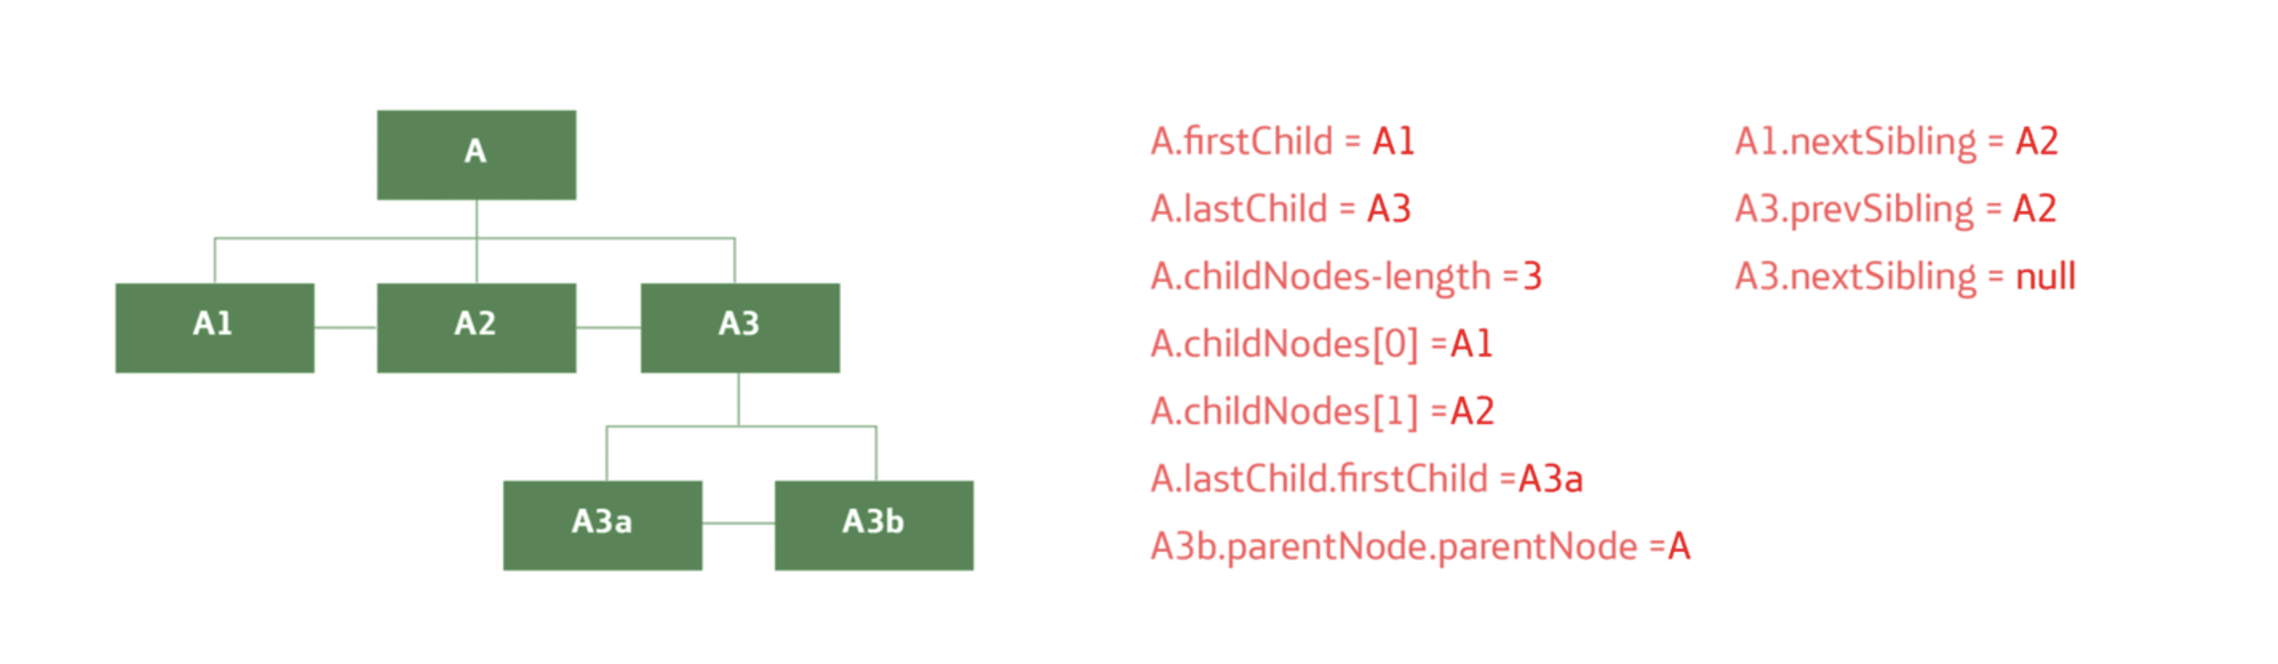
Cuando se crea el DOM los lenguajes de programación deben ser capaces de recorrer sus diferentes partes, para este fin cada nodo (objeto) dispone de atributos y métodos basados en el parentesco entre los nodos.
Uno de ellos, y el más utilizado, es el childnodes, que nos lista los elementos que contiene el nodo padre.
Una vez nos encontramos en un nodo podemos acceder a otros nodos aún cuando no sepamos sus identificadores.
- childNodes: es una matriz (array) que contiene todos los nodos hijos de un elemento.
- getAttribute(id): devuelve el valor del atributo que identificamos por el parámetro id.
- parentNode: accede al nodo padre, o lo que es lo mismo, al nodo en el que se encuentra.
- firstChild y lastChild: contienen, respectivamente, el primer y último hijo de un nodo.
- previousSibling y nextSibling: para acceder a los hermanos del nodo en orden secuencial.
- hasChildNodes(): devuelve un valor booleano, indicando si el nodo tiene hijos.